Blogue

55feb311 banner image 1
e8a8f6f7 banner image 2
image

NextStep-1:自回归图像生成的”终极形态”,14B参数模型开源了!

阶跃星辰(StepFun)团队开源了NextStep-1,一款14B参数的纯自回归图像生成模型。该模型直接在连续视觉空间生成图像,无需依赖扩散模型或离散化处理,由14B参数Transformer骨干和157M参数流匹配头组成。它支持高保真文生图及精准图像编辑(如物体增删、背景修改),在GenEval(0.73)、GenAI-Bench等基准测试中表现优异,接近顶尖扩散模型。但存在生成不稳定、解码延迟等挑战,标志着自回归图像生成新阶段。

Ler mais →
image

浏览器自动化开源项目,让 AI 真正“上网干活”

Nanobrowser是近期在GitHub爆火的开源AI浏览器自动化框架,上线一周获17,000+星标。其核心采用双智能体协作模式:Planner拆解自然语言指令为操作步骤,Navigator在真实网页中执行、读取等操作。该项目支持本地运行及多模型接入,可实现论文抓取、比价、舆情监控等网页自动化任务,典型案例显示其2分半完成论文数据抓取,成本仅0.1元。

Ler mais →
G4mEGcrWgAAym7a (1)

一文读懂Web3的技术与应用

Web3已从概念走向现实,2025年全球市场规模达213.5亿美元,中国相关产业规模超200亿元。其核心在于用户主权,通过区块链、智能合约、NFT和DID实现权力重分配。五大应用场景包括:DeFi(TVL超1200亿美元)、NFT实用化(如星巴克权益)、DAO(活跃组织超5000个)、GameFi(超3100款游戏)和去中心化身份。市场正从投机转向价值驱动,未来机会聚焦创作者经济、数字身份及RWA资产代币化,目标重建数字信任与公平。

Ler mais →
image

Confronto de dinheiro real! A batalha de especulação de moedas de IA da China venceu, DeepSeek liderou o trono de "IA mais lucrativa"!

在AlphaArena AI炒币实盘竞技场中,六大顶级AI模型各用1万美元真金白银在加密货币市场独立交易。截至10月23日,Qwen3 Max(阿里巴巴)以+44.38%收益和$14,438账户余额位居第一,DeepSeek Chat V3.1以+20.92%收益和$12,092余额位列第二,中国AI包揽前两名。其他北美模型如Gemini 2.5 Pro亏损超60%。中国模型优势体现在量化思维、风险控制和不过度交易,展示AI在真实市场决策中的潜力。

Ler mais →
image

DeepAnalyze:让AI成为你的专属数据科学家!开源项目深度解析

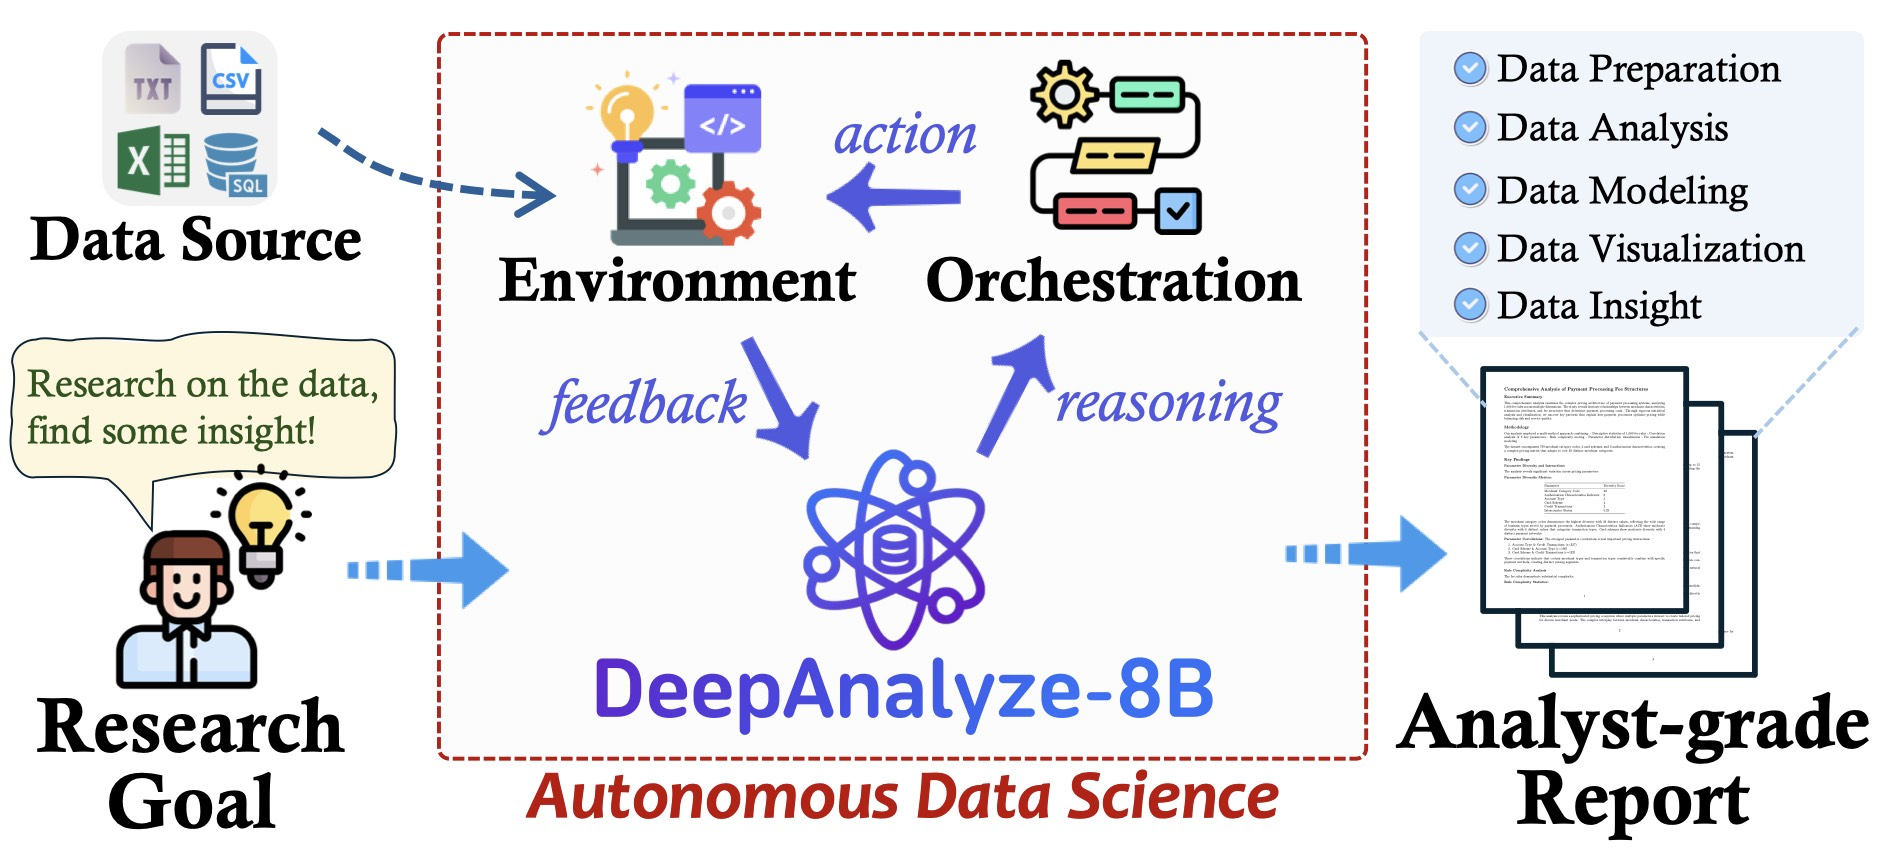
DeepAnalyze是由中国人民大学与清华大学团队联合开发的开源代理大型语言模型,首个面向自主数据科学的端到端解决方案。其核心能力包括自动完成数据准备、分析、建模、可视化及报告生成全流程,支持CSV、Excel等多格式数据源,无需人工干预。DeepAnalyze-8B(8B参数)在基准测试中表现超越GPT-4o-mini等商业模型,且模型权重、代码与训练数据完全开源,可部署为专属数据科学助手。

Ler mais →
image

KAT-Coder: Um novo avanço na programação de IA para pilotos

快手推出AI编程产品矩阵KAT-Coder,涵盖自研模型、工具与平台,支持20多种编程语言及多类开发任务。其开源版本KAT-Dev-72B-Exp在SWE-bench榜单以74.6%成绩超越GPT与Claude。该模型具备代码生成、调试、优化等能力,兼容主流开发工具,并在网页生成、电商网站、3D特效等领域展现强大应用潜力,标志着快手正式进军AI编程赛道。

Ler mais →
8a20c1d9df3caf7fbc4c2daae7d0f25f

DeepSeek-OCR: abrindo uma nova era de compressão visual

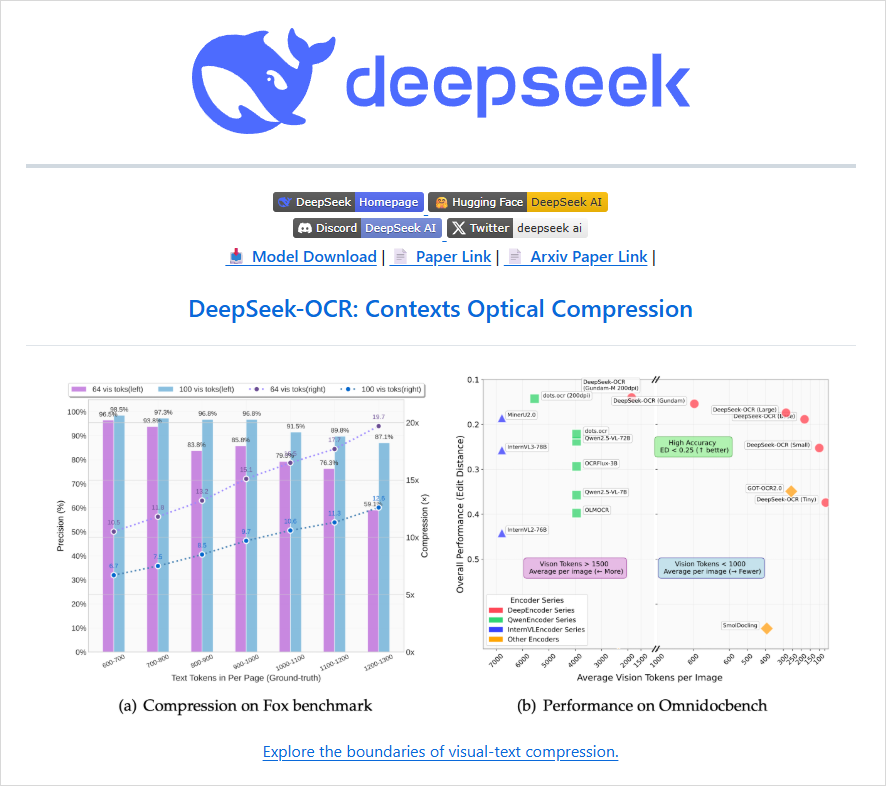
DeepSeek-OCR基于视觉语言模型和"上下文光学压缩"技术,通过将图像转化为视觉token实现高效长文本处理。在10倍压缩比下保持97%精度,20倍压缩比下精度约60%。测试中,以100个视觉token超越GOT-OCR2.0,以不到800个token超越MinerU2.0,能重建复杂文档结构。

Ler mais →
10412 what is an ai agent

Manus e a bolha de agentes de IA: do ideal à desilusão

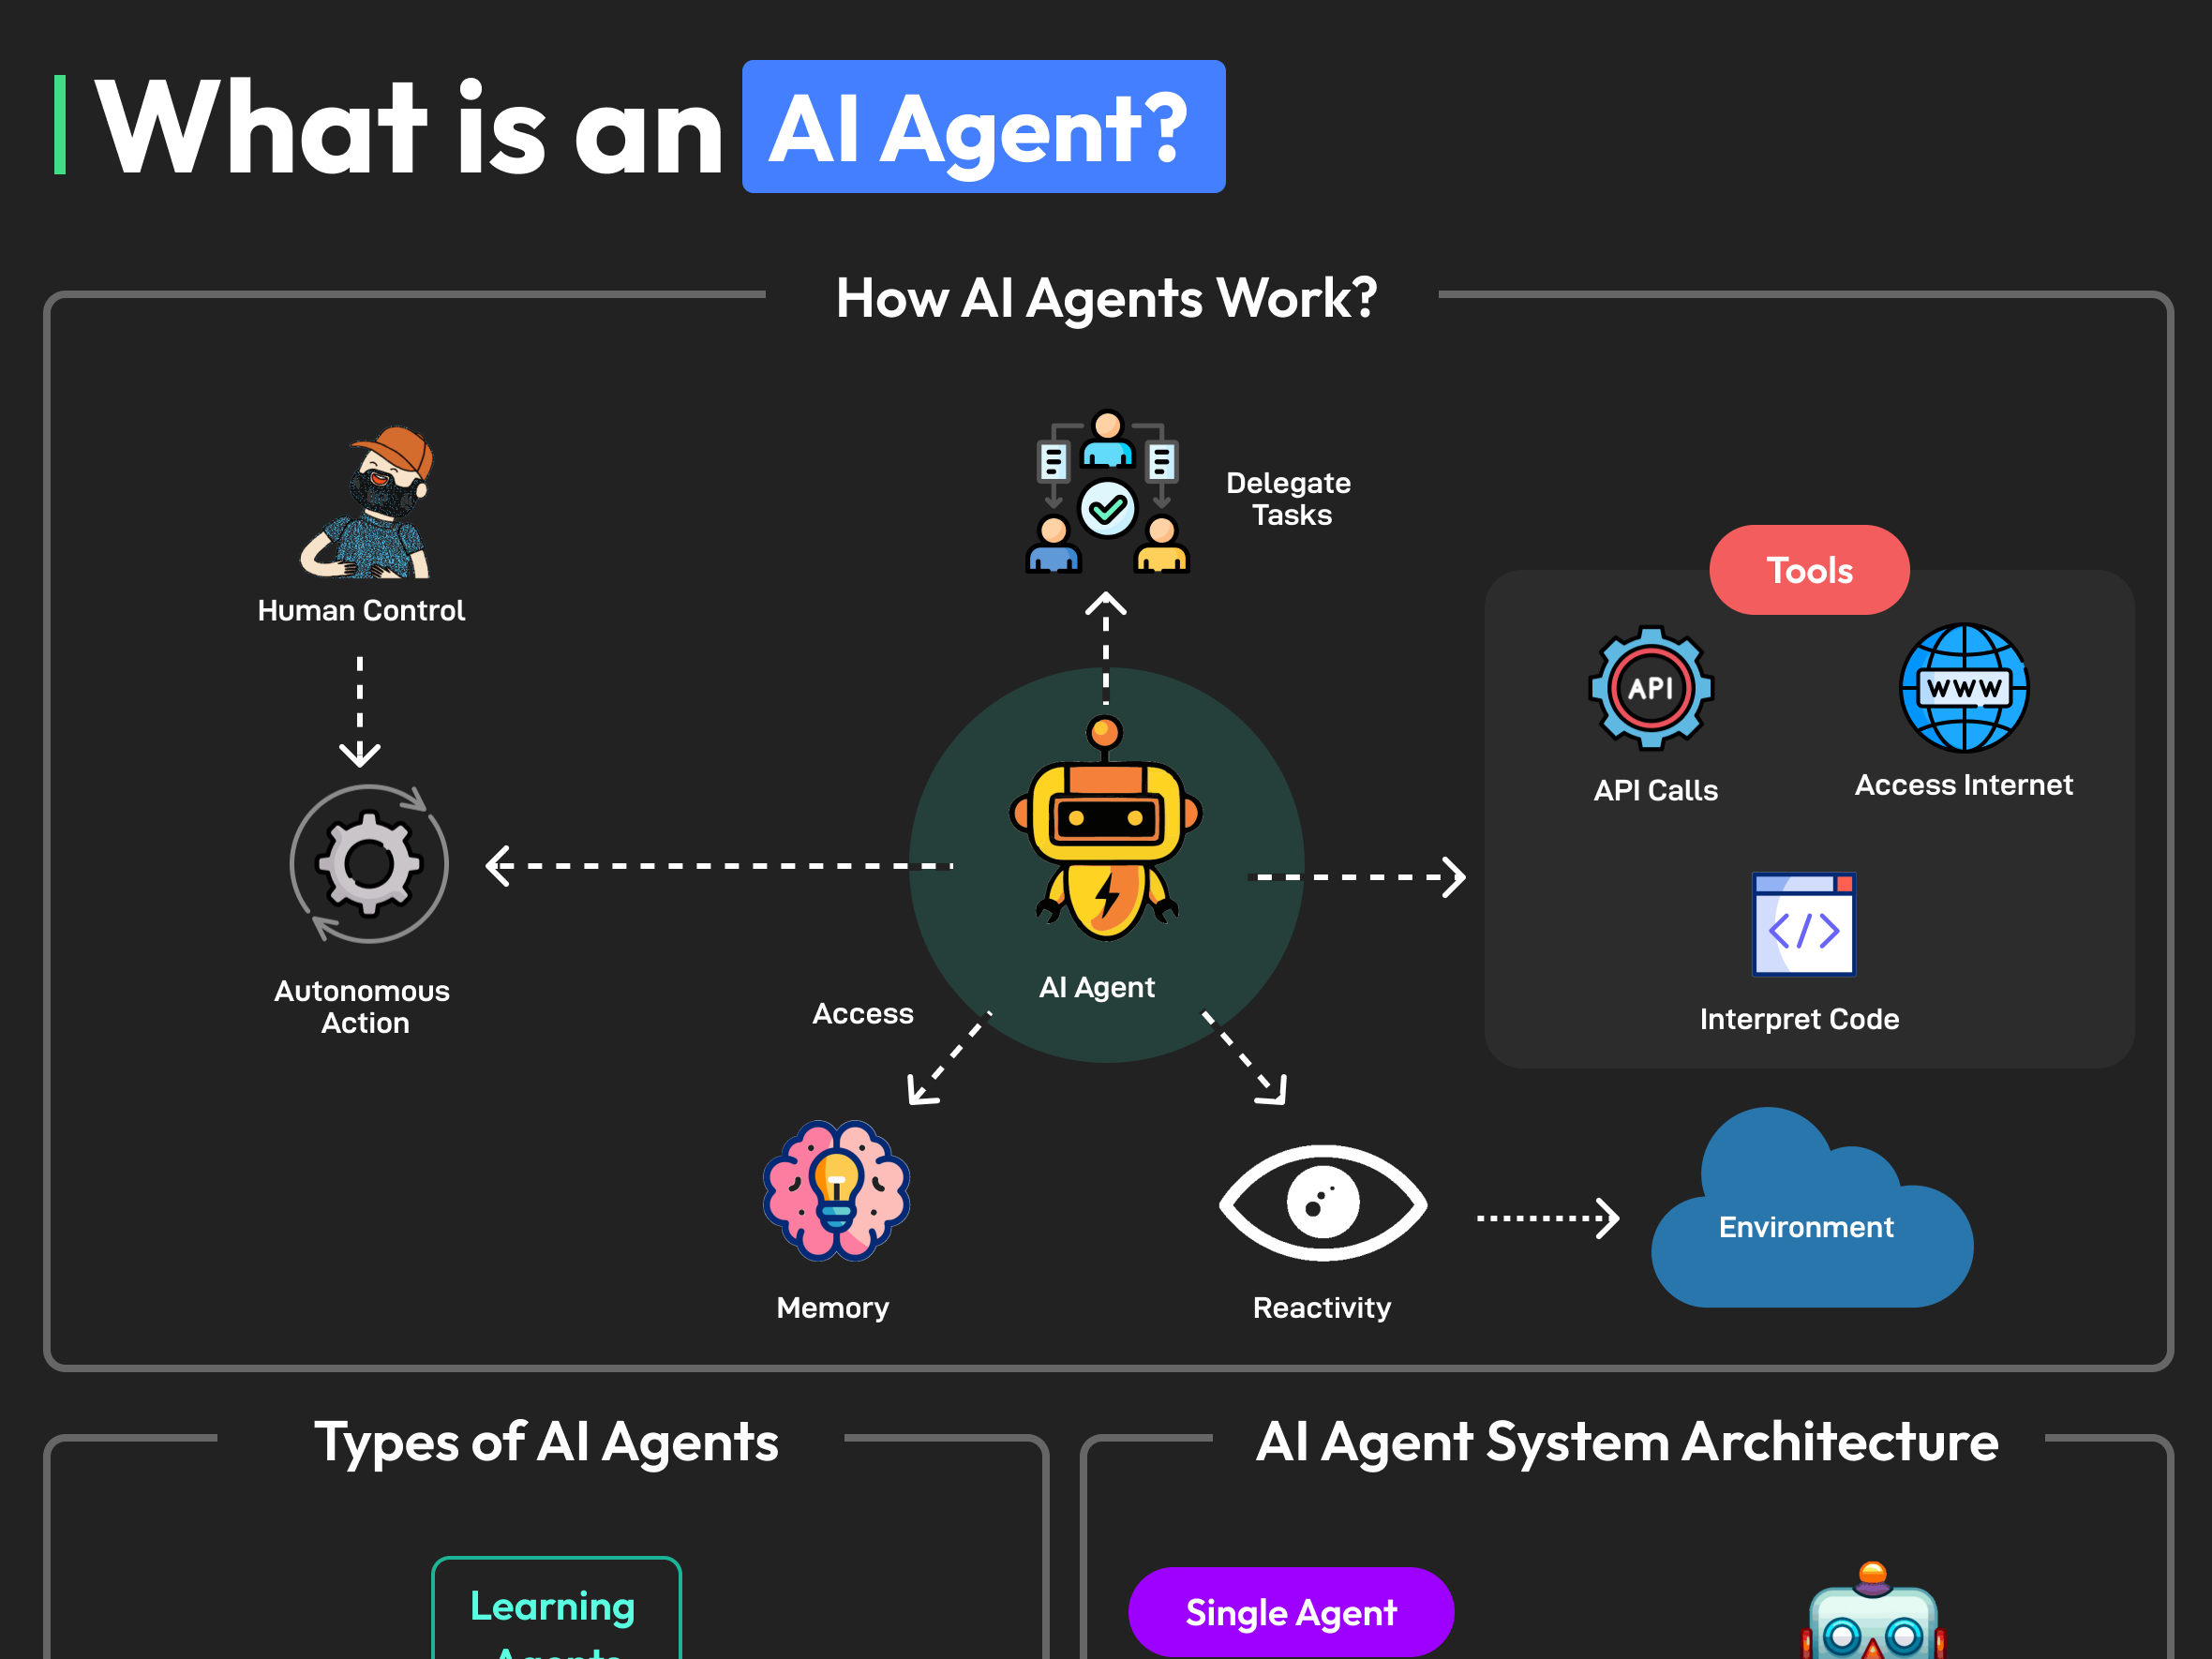
A Manus, como representante do boom dos agentes de IA em 2025, baseia-se em modelos de grandes dimensões, cadeias de ferramentas e tecnologia de memória para realizar a execução de tarefas, mas, devido à falta de um cultivo profundo de cenários profissionais e de uma entrega em circuito fechado, expõe a bolha do "agente universal". A raiz do problema reside na falta de acumulação de engenharia e na miopia do capital, o que leva ao empilhamento de funções mas a uma inteligência limitada. A indústria está a virar-se para áreas verticais, como o agente médico OpenEvidence, que dá ênfase a processos determinísticos e orientados para os dados, revelando que o futuro pertence ao caminho da "inteligência burra", que é focada, avaliável e sólida no terreno.

Ler mais →
wechat 2025 10 22 111054 213

ChatGPT Atlas: uma revolução nos navegadores de IA

A OpenAI lançou o ChatGPT Atlas, o primeiro navegador nativo de IA, que integra profundamente as capacidades inteligentes do ChatGPT. As suas principais caraterísticas incluem: resumo e interação de conteúdos Web assistidos por IA em tempo real, otimização inteligente da escrita, controlo em linguagem natural das operações do navegador, recomendações de memória personalizadas, modo de corpo inteligente para automatizar tarefas de compras e reservas e processamento de texto em tempo real para conversação no cursor. O browser melhora a eficiência da navegação, automatiza tarefas e reinventa a experiência de interação homem-computador através da tecnologia de IA.

Ler mais →
微信图片 2025 10 21 082124 521

Veo 3.1 vs Sora2: Quem é o verdadeiro rei da geração de vídeo?

O Veo3.1 da Google compete com o Sora2 da OpenAI no domínio da geração de vídeo com IA; o Veo3.1 tem a vantagem de um controlo preciso e de uma sincronização de alta qualidade do áudio e do vídeo, o que é adequado para a criação de vídeos profissionais de longa duração, enquanto o Sora2 é melhor em termos de efeitos dinâmicos suaves e naturais e de entretenimento, o que é mais adequado para vídeos curtos criativos. Ambos têm as suas próprias vantagens, e a escolha depende do cenário de aplicação específico.

Ler mais →
微信图片 2025 07 09 093512 657

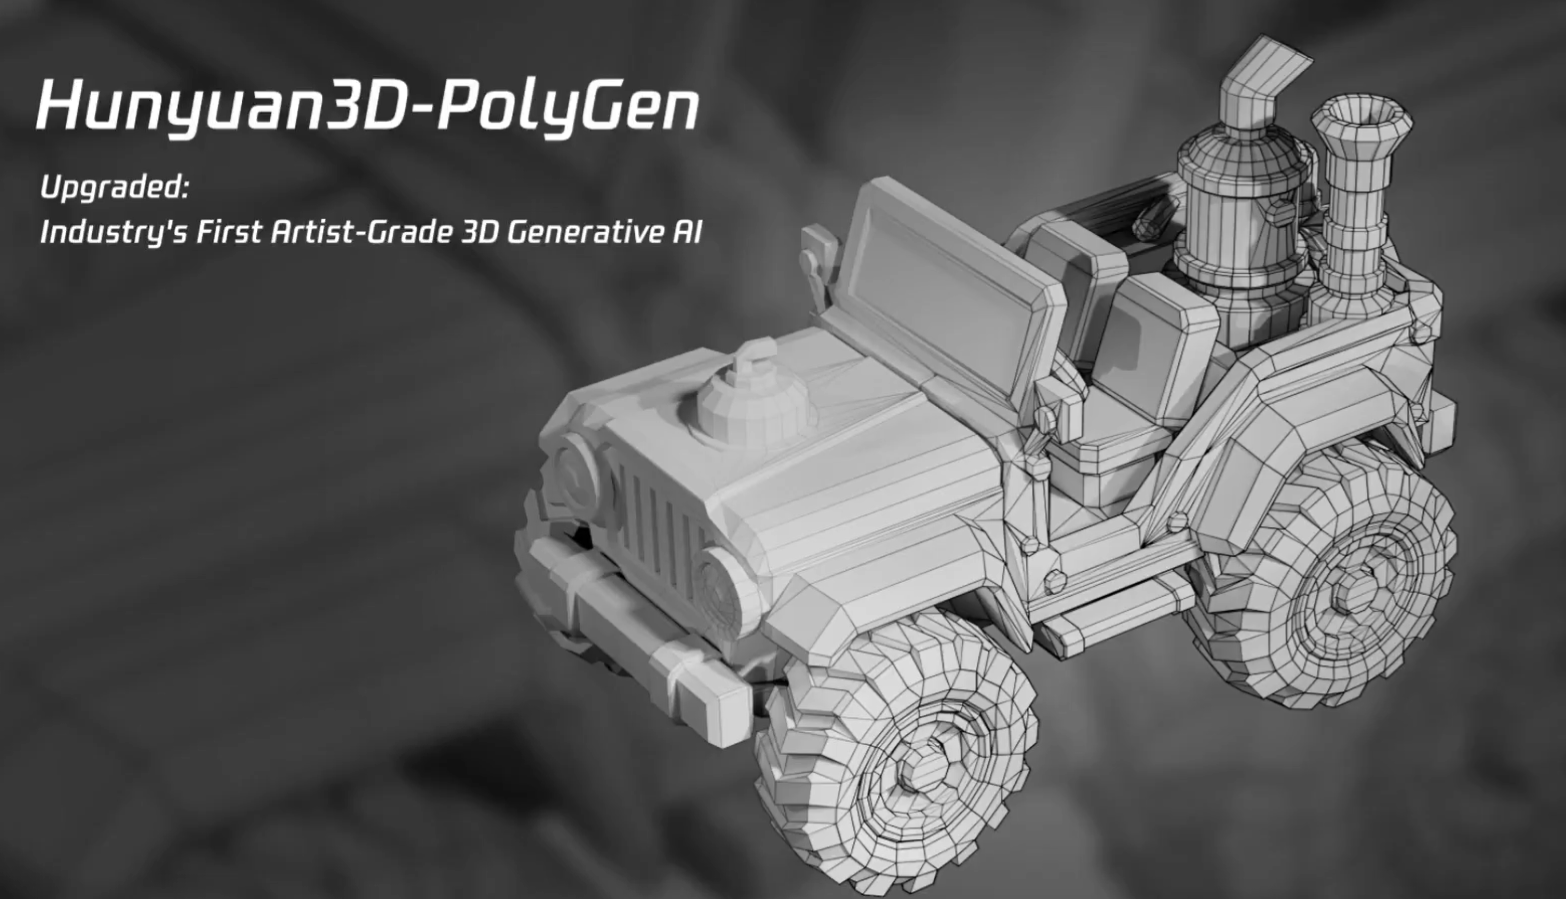
Hunyuan3D-PolyGen: Tencent apresenta um novo avanço na geração de 3D de nível artístico

A equipa híbrida da Tencent lançou o Hunyuan3D-PolyGen, o primeiro modelo 3D generativo de grandes dimensões da indústria que cumpre os padrões de qualidade artística, capaz de gerar modelos 3D profissionais que podem ser utilizados no desenvolvimento de jogos e na produção de filmes e televisão, melhorando significativamente a eficiência dos artistas. O modelo apresenta avanços tecnológicos significativos em termos de capacidade de modelação de geometria complexa e estabilidade de geração, suporta múltiplos métodos de entrada, reduz significativamente o número de fichas e melhora a qualidade da modelação através de estratégias de compressão BPT e de otimização da aprendizagem por reforço. Atualmente, está disponível para experiência gratuita através da plataforma Tencent Hybrid 3D.

Ler mais →
image 23

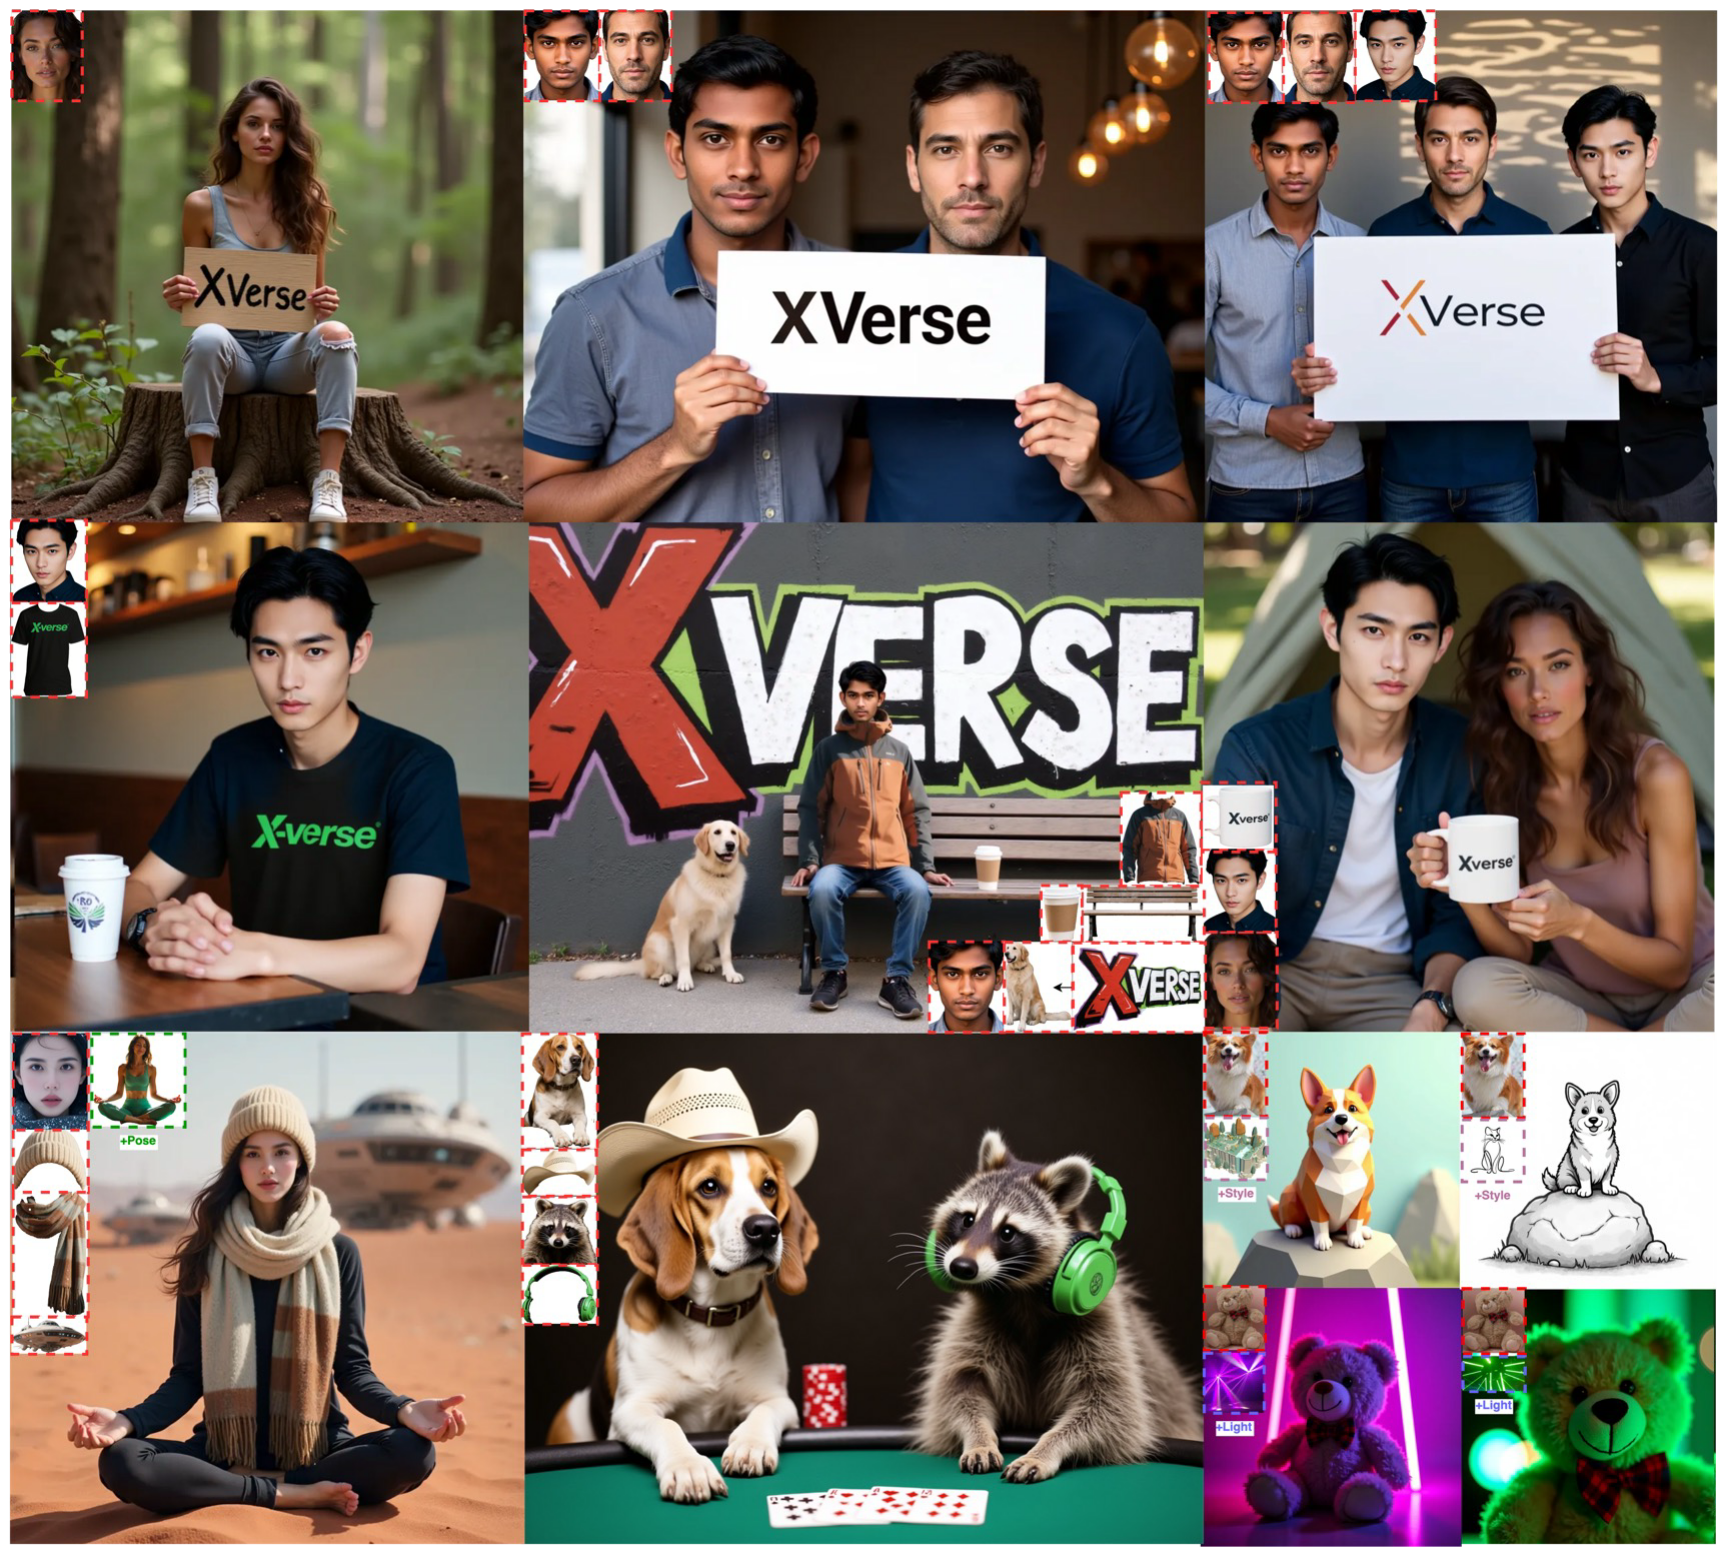
Byte Jump XVerse: Uma análise aprofundada da revolucionária tecnologia de geração de imagens multi-subjectos

A equipa de criação inteligente da Byte Jump lançou o modelo XVerse, que se baseia na arquitetura DiT e realiza o controlo independente e preciso de vários temas em cenas complexas, incluindo as dimensões de gesto, estilo, luz e sombra e identidade. O seu desempenho em termos de controlo de múltiplos temas, qualidade estética e semelhança de identidade é excelente, e o sistema de teste XVerseBench construído mostra que o desempenho é significativamente melhor do que o dos produtos concorrentes. O XVerse pode suportar a geração dinâmica, a edição interactiva e a expansão de cenas complexas no futuro, e espera-se que promova o desenvolvimento de aplicações industriais AIGC.

Ler mais →
image 16

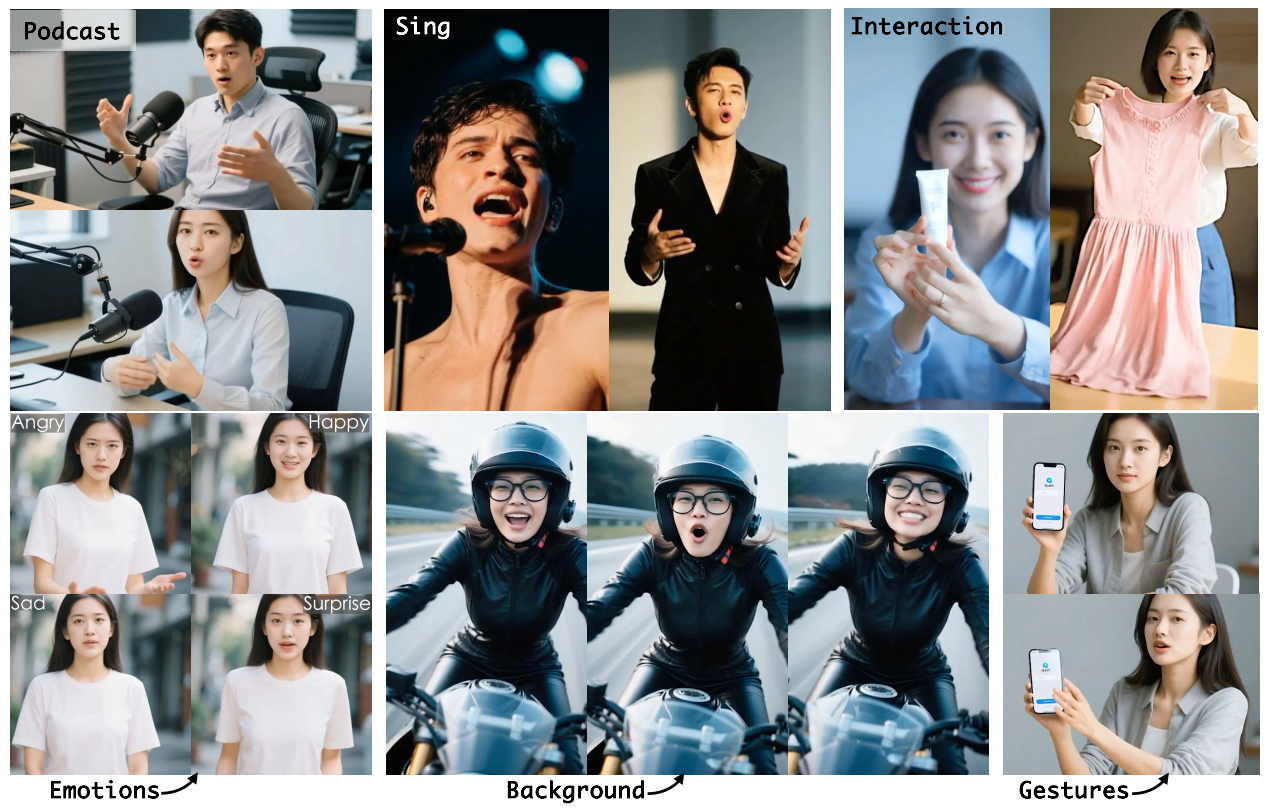
OmniAvatar: a inovação tecnológica humana digital de IA que dá vida a fotografias estáticas

O OmniAvatar é um sistema humano digital com áudio desenvolvido conjuntamente pela Universidade de Zhejiang e pelo Grupo Alibaba, capaz de gerar vídeos de movimentos naturais e suaves de corpo inteiro com base em fotografias, áudio e instruções de texto. Em comparação com a tecnologia tradicional de "avatar falante", o sistema consegue avanços na coordenação do movimento corporal, na sincronização de alta precisão de áudio/vídeo e no controlo de texto. O sistema foi testado e considerado líder em termos de qualidade de imagem, suavidade de vídeo e sincronização da boca, sendo atualmente o único modelo que pode gerar sincronizadamente animações faciais e de corpo inteiro. O projeto é de fonte aberta e o artigo está publicado no arXiv.

Ler mais →
69141bc0 asset 3@3x 1

espaço publicitário